MANIPULATION DE DONNEES EN CSV
Objectif : Avant de plonger dans le langage SQL et les bases de données relationnelles, il est fondamental de comprendre comment stocker, explorer et manipuler des données tabulaires "plates". Le format CSV (Comma-Separated Values) est le format universel d'échange de données. Nous allons l'explorer sur un catalogue de films puis sur un fichier réel de 44 000 lignes issues d'une caméra de surveillance intelligente.
Téléchargez le premier fichier de travail : 📥 catalogue_films.csv. Enregistrez-le sur votre bureau ou dans votre dossier personnel.
1 - Le piège de l'importation et du séparateur
Un fichier CSV est un simple fichier texte brut : chaque ligne correspond à un enregistrement et les colonnes sont délimitées par un caractère spécial (virgule , ou point-virgule ;).
@1 Que se passe-t-il si vous faites un simple "double-clic" sur le fichier CSV sous Windows ? Pourquoi les accents risquent-ils de s'afficher sous forme de caractères bizarres (ex: é) ?
Solution :
Un double-clic ouvre le fichier avec les réglages par défaut du système d'exploitation. Si le séparateur par défaut de Windows ne correspond pas à celui du fichier, tout le texte reste coincé dans la première colonne ! De plus, si l'encodage par défaut (ex: Windows-1252) ne correspond pas à l'encodage du fichier (ici UTF-8), tous les caractères accentués sont corrompus.
Pour importer proprement le fichier dans LibreOffice Calc :
1. Ouvrez d'abord LibreOffice Calc (classeur vide).
2. Allez dans Fichier > Ouvrir et sélectionnez catalogue_films.csv.
3. La boîte de dialogue d'importation de texte s'affiche.
- Jeu de caractères : sélectionnez Unicode (UTF-8).
- Options de séparateur : cochez Point-virgule uniquement.
@2 Le mystère de la dernière colonne sans titre :
Certains élèves remarquent qu'après l'importation, une 8e colonne apparaît tout à droite (colonne H) contenant des chiffres isolés (ex: 6, 9, 0...), mais sans aucun titre dans la première ligne.
D'où vient cette colonne fantôme et quelle case faut-il décocher dans les options d'importation pour régler le problème ?
Solution :
Dans notre fichier, les notes de la colonne Note_sur_10 sont écrites avec une virgule décimale (ex: 4,6).
Si l'élève laisse la case "Virgule" cochée en plus de "Point-virgule" dans les séparateurs de Calc, le logiciel coupe la cellule en deux à chaque virgule ! Le 4 reste dans la colonne Note_sur_10, et le 6 est envoyé dans une nouvelle colonne à droite, sans en-tête.
Pour corriger : il faut cocher uniquement "Point-virgule" et bien décocher "Virgule". La note redevient un seul nombre décimal propre : 4,6.
2 - Recherche ciblée d'un film (Le futur WHERE avec LIKE ou =)
Quand une table comporte 2000 entrées, il est impossible de faire défiler la page pour trouver un film à l'œil nu.
@3 Vous cherchez le film intitulé "Le Sombre Vaisseau", ou tous les films contenant le mot "Océan" dans leur titre. Comment effectuer cette recherche ciblée dans Calc ? Indiquez au moins deux méthodes (avec la recherche rapide et avec l'AutoFiltre).
Solution :
- Méthode 1 (Recherche globale) : Utiliser le raccourci
Ctrl + F(ouÉdition > Rechercher...), taperOcéanpuis naviguer avec "Suivant" pour trouver les occurrences correspondantes. - Méthode 2 (Filtrage de la colonne) : Activer l'AutoFiltre (
Données > AutoFiltre), cliquer sur la flèche de la colonneTitre, puis taperOcéandans le champ de recherche du filtre pour masquer instantanément tous les autres films. En SQL, cette recherche ciblée s'écrira : - Film exact :
SELECT * FROM films WHERE Titre = 'Le Sombre Vaisseau'; - Contient un mot-clé :
SELECT * FROM films WHERE Titre LIKE '%Océan%';
3 - Trier les données (Le futur ORDER BY)
Une fois les données en place, on souhaite classer les enregistrements selon plusieurs critères.
@4 Sélectionnez votre tableau et allez dans Données > Trier.... Comment trier l'ensemble des 2000 films par Année de sortie décroissante (des plus récents aux plus anciens), puis, pour les films sortis la même année, par Note décroissante (les mieux notés en premier) ?
Solution :
Dans la boîte de dialogue de tri à critères multiples :
- Clé de tri 1 : Colonne Annee, cocher Décroissant.
- Clé de tri 2 : Colonne Note_sur_10, cocher Décroissant.
Cela préfigure fidèlement la clause SQL :
ORDER BY Annee DESC, Note_sur_10 DESC;
4 - Filtrer les données par critères (Le futur WHERE conditionnel)
Filtrer permet de masquer les données superflues pour n'afficher qu'un sous-ensemble pertinent.
@5 Avec l'AutoFiltre actif (Données > AutoFiltre), expliquez la démarche pour n'afficher que les films du genre "Science-Fiction" sortis strictement après l'année 2000.
Solution :
- Sur la colonne
Genre: cliquer sur la flèche, décocher "Tout" et ne cocher que Science-Fiction. - Sur la colonne
Annee: cliquer sur la flèche, aller dans "Filtre standard..." et définir la condition :Annee>2000. En base de données relationnelles, on écrira la requête SQL correspondante :SELECT * FROM films WHERE Genre = 'Science-Fiction' AND Annee > 2000;
5 - Calculer et Agréger (Le futur COUNT, AVG, SUM)
Les tableurs permettent d'effectuer des calculs d'agrégation sur des plages entières de données. Dans notre fichier, les données vont de la ligne 2 à la ligne 2001 (soit 2000 films au total).
Les colonnes sont réparties ainsi :
- Colonne A : ID
- Colonne B : Titre
- Colonne C : Realisateur
- Colonne D : Annee
- Colonne E : Genre
- Colonne F : Duree_min
- Colonne G : Note_sur_10
@6 1. Quelle formule permet de calculer la note moyenne des 2000 films (colonne G) ? 2. Quelle formule permet de calculer la durée totale en minutes de tous les films réunis (colonne F) ? 3. Quelle formule permet de compter automatiquement le nombre total de films à partir de leurs identifiants (colonne A) ?
Solution :
- Note moyenne :
=MOYENNE(G2:G2001) - Durée totale :
=SOMME(F2:F2001) - Nombre de films :
=NB(A2:A2001)(ou=NBVAL(B2:B2001)sur les titres)
En SQL, ces calculs statistiques s'effectuent à l'aide des fonctions d'agrégation :
SELECT AVG(Note_sur_10), SUM(Duree_min), COUNT(*) FROM films;
6 - Grandeur Nature : 44 000 données d'une Caméra de Surveillance (dataelement.csv)
Vous avez manipulé avec succès un fichier de 2 000 films. Passons maintenant à l'échelle industrielle !
Téléchargez le fichier de données réelles : 📥 dataelement.csv.
Ce fichier contient plus de 44 700 lignes générées automatiquement par une caméra de surveillance équipée d'un processeur IA embarqué (type Raspberry Pi ou Nvidia Jetson avec un réseau de neurones de détection d'objets en temps réel).
Structure des données
Les colonnes enregistrées sont :
* date et time : l'instant précis de la détection.
* Objet détecté : VOITURE ou PERSONNE.
* centerX et centerY : coordonnées $(X, Y)$ du centre de l'objet dans l'image (en pixels).
* valeurX et valeurY : largeur et hauteur de la boîte englobante (bounding box).
* confidence : score de certitude de l'IA (entre 0 et 1).
* temperature : température du microprocesseur embarqué.
@7 Enquête de télémesure :
Ouvrez le fichier dans Calc (attention, avec 44 000 lignes le chargement peut prendre quelques secondes !).
Filtrez les données sur une séquence continue (par exemple le 17/10/2020 entre 09:32:56 et 09:33:30).
1. Comparez les coordonnées centerX et centerY de la VOITURE et de la PERSONNE. Que constatez-vous ?
2. La voiture bouge-t-elle ? Comment expliquez-vous que sa coordonnée $X$ oscille très légèrement entre 336.5 et 338.0 ?
3. Quelle est la trajectoire de la personne ? Que remarquez-vous sur la taille de sa boîte englobante et sur l'indice de confidence à mesure qu'elle avance ?
Solution :
- La voiture est stationnaire (garée) : ses coordonnées restent bloquées à $X \approx 337$ et $Y \approx 197$, avec une boîte constante de $183 \times 90$ pixels.
- Le bruit de détection (jitter) : Les infimes variations ($\pm 0.5$ à $1$ pixel) ne sont pas un mouvement de la voiture, mais l'imprécision normale de l'algorithme d'IA d'une image à l'autre !
- La personne est en mouvement actif vers la caméra : Sa coordonnée $X$ passe de $624 \rightarrow 590$ et $Y$ de $579 \rightarrow 602$ (trajectoire diagonale). Sa boîte s'élargit et le score de confiance grimpe de $0.78$ à $0.99$ au fur et à mesure qu'elle se rapproche de l'objectif !
Visualisation graphique de la scène
Voici la reconstitution visuelle générée à partir des coordonnées réelles de cette séquence :
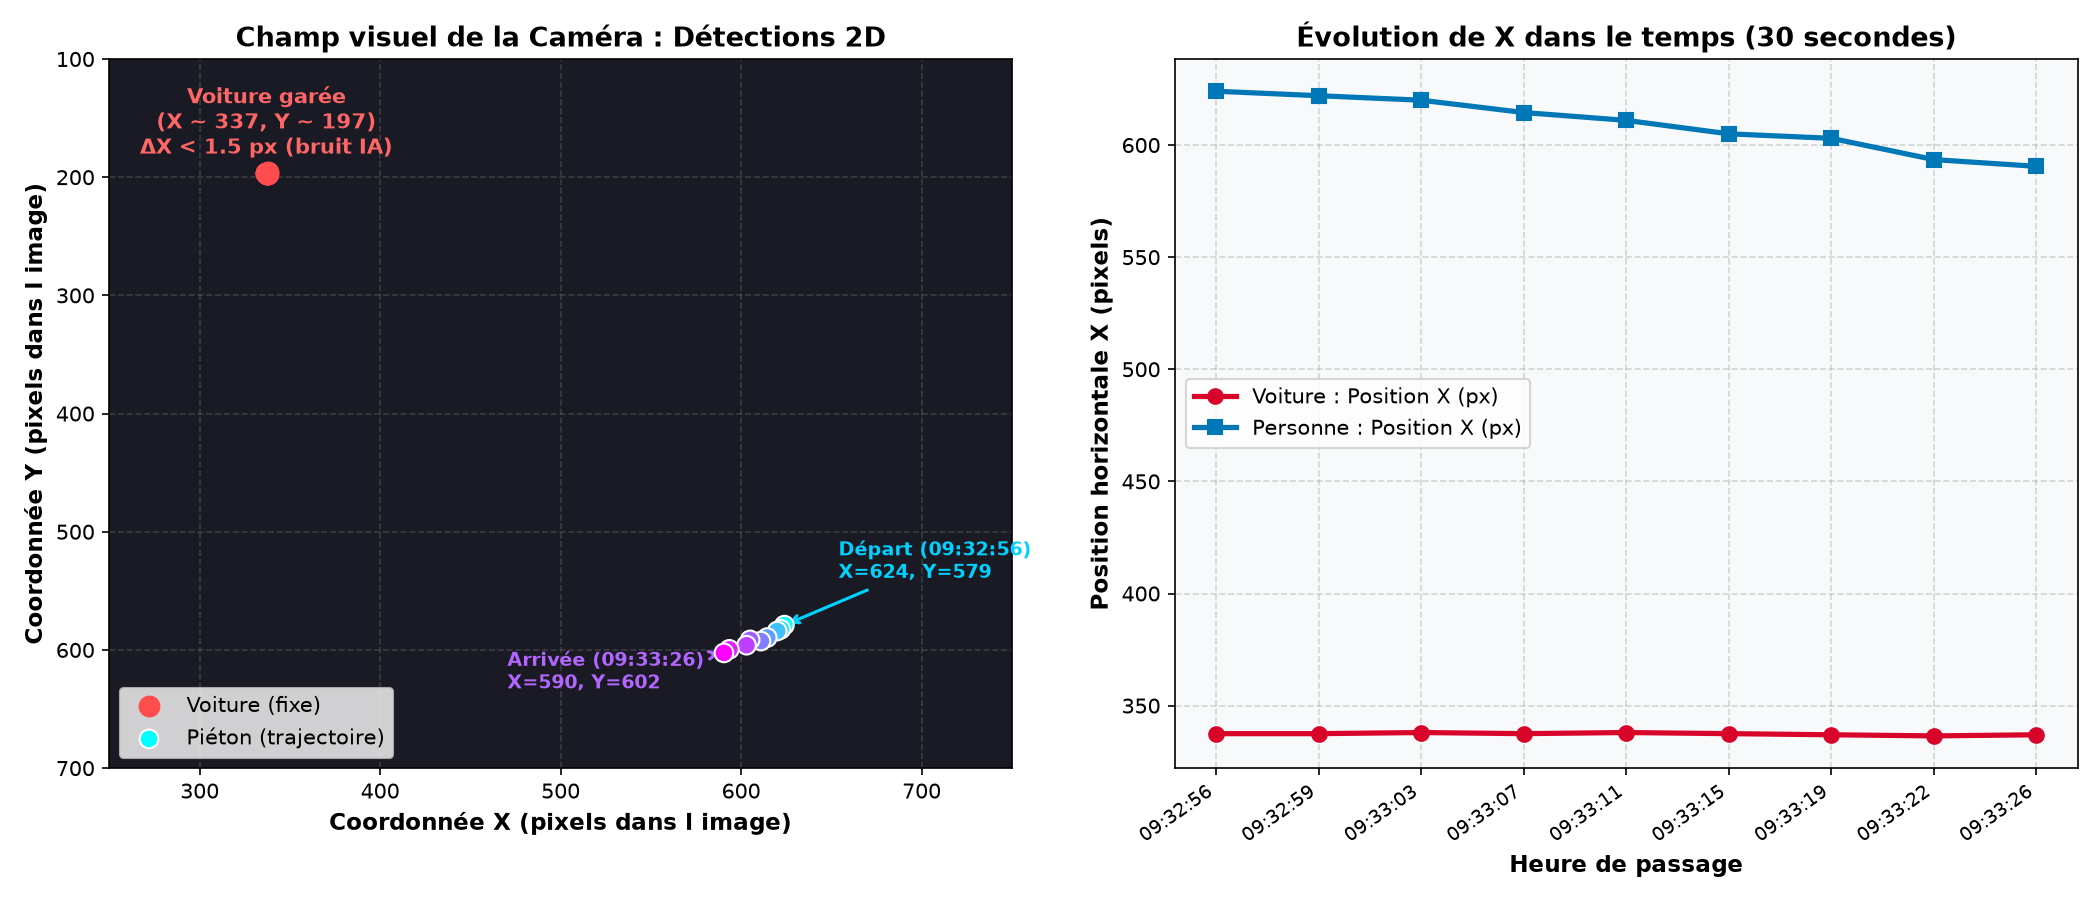
@8 Visualisation en Python (Script d'analyse) : Voici le script Python permettant d'extraire automatiquement ces 44 000 lignes et de tracer la trajectoire sans faire ramer un tableur. Vous pouvez le copier dans votre environnement Python (Thonny, VS Code) pour afficher le graphique interactif :
import csv
import matplotlib.pyplot as plt

# Listes pour stocker les coordonnées
car_x, car_y = [], []
pers_x, pers_y = [], []

with open("dataelement.csv", "r", encoding="utf-8", errors="ignore") as f:
    reader = csv.reader(f, delimiter=";")
    next(reader)  # Sauter l'en-tête

    for row in reader:
        # Repérer les lignes contenant les étiquettes
        if "VOITURE" in row:
            idx = row.index("VOITURE")
            car_x.append(float(row[idx+1]))
            car_y.append(float(row[idx+2]))
        elif "PERSONNE" in row:
            idx = row.index("PERSONNE")
            pers_x.append(float(row[idx+1]))
            pers_y.append(float(row[idx+2]))

# Tracé graphique avec Matplotlib
plt.figure(figsize=(10, 6))
plt.scatter(car_x[:50], car_y[:50], color="red", label="Voiture (Point fixe stationnaire)", s=50)
plt.plot(pers_x[:50], pers_y[:50], "b-o", label="Personne (Trajectoire en marche)", markersize=5)

plt.gca().invert_yaxis()  # Repère image : Y inversé (0 en haut)
plt.xlabel("Position X (pixels)")
plt.ylabel("Position Y (pixels)")
plt.title("Détection Caméra : Voiture fixe vs Piéton mobile")
plt.legend()
plt.grid(True, linestyle="--", alpha=0.5)
plt.show()
Bilan de transition : Sur 44 000 lignes, vous avez constaté que LibreOffice Calc commence à montrer ses limites (lenteur, difficulté à corréler plusieurs tables en même temps). Pour traiter en temps réel des millions d'événements de caméras, de capteurs ou de transactions, les ingénieurs utilisent des Bases de Données (SGBD) avec le langage SQL. C'est exactement l'objet du chapitre suivant !